Dans tous les chantiers IA que nous menons, avec des directions juridiques comme avec des cabinets d’avocats, on finit par se heurter à la même question. Le choix du modèle passe au second plan. Le nerf de la guerre, c’est la donnée : être capable de la connecter à l’IA, et de le faire de façon sécurisée.
Livrer la donnée à l’IA, avec le bon niveau de protection
Toutes les données ne se traitent pas de la même façon, et toutes les IA non plus. Selon l’IA qui reçoit le document et selon le document lui-même, on a besoin de plus ou moins de protection.
Parfois, il faut pseudonymiser. Chaque personne, chaque société, chaque lieu devient un code avant l’envoi, et les vrais noms restent chiffrés à part. Ils ne sont rétablis que pour les personnes habilitées, et chaque ré-identification est tracée. Dans tous les cas, les droits d’accès s’appliquent : chacun ne voit que les dossiers auxquels il a droit.
Il ne s’agit donc pas de tout envoyer ou de ne rien envoyer. La même donnée peut partir plus ou moins protégée, selon l’IA qui la reçoit.
Contextualiser : une pièce n’arrive jamais seule
Livrer la donnée ne suffit pas, il faut aussi la contextualiser. Prenons un contrat. Pour que l’IA le comprenne, il faut souvent lui envoyer ses annexes, et ses mises à jour : les avenants, les versions successives. Sans cela, elle peut lire la V3 d’un bail sans savoir qu’une V5 signée existe, ou qu’un avenant a modifié une clause.
Il faut aussi découper. Un contrat se coupe par articles, un tableau par lignes, une réunion par prises de parole. C’est ce découpage qui permet à l’IA de retrouver le bon passage au lieu de se perdre dans un long document.
Concrètement, quand une pièce arrive dans le Datahub, elle est lue (avec reconnaissance de caractères pour un scan), typée (contrat, bail, facture, assignation…), découpée selon son type, pseudonymisée, puis décrite : les parties, les dates, les montants, le statut. Elle est enfin indexée, pour qu’on puisse la retrouver par mots et par sens. Et elle est reliée aux autres : cette version remplace celle-ci, cet avenant la modifie, cette annexe l’accompagne.
Un exemple. On demande : « Donne-moi la dernière version du bail et ce qui l’a modifié. » Sans lien entre les pièces, l’IA reçoit onze documents, mails compris, et peut répondre avec une version jamais signée. Avec, elle en reçoit trois : la version qui fait foi et les deux avenants qui la modifient. Elle lit moins, elle tombe sur la bonne version, et elle sait qui sont les parties.
Une seconde mémoire
C’est pour cela que nous parlons de seconde mémoire. Un cabinet a déjà une mémoire, éclatée : les documents dans la GED, les échanges dans les e-mails, les décisions dans les comptes rendus de réunion, les échéances dans les agendas. Aucune IA ne voit tout cela d’un coup.
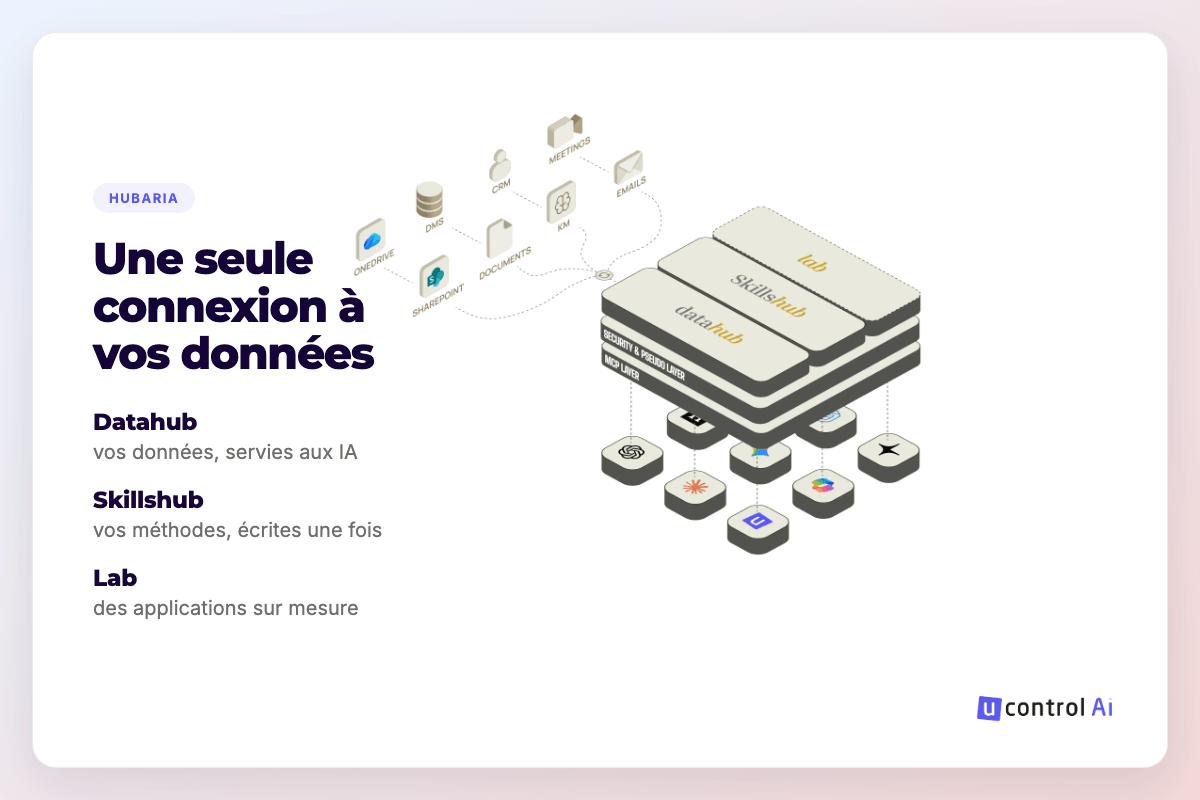
Le Datahub fait quatre choses :
- Rassembler : vos sources sont raccordées une fois.
- Rapprocher : un dossier, toutes ses sources.
- Protéger : vos droits d’accès sont appliqués, les noms sont remplacés par des pseudonymes.
- Servir : chaque IA reçoit la même donnée, que ce soit Claude, ChatGPT, Copilot ou uControlAi.
On peut alors lui poser des questions de tous les jours :
- « Avons-nous déjà négocié cette clause ? » Les contrats qui la portent, comment elle a évolué, et l’argument qui avait emporté la décision.
- « Qu’est-ce qui tombe ce mois-ci ? » Audiences, délais et relances en attente, repérés dans les agendas, les e-mails et les actes.
- « Je reprends ce dossier, que dois-je savoir ? » L’historique, les positions déjà défendues, les interlocuteurs et les prochaines étapes.
Vos données restent les vôtres, sécurisées, jamais confiées en clair à une IA. Pour le détail du module, rendez-vous sur la page du Datahub.